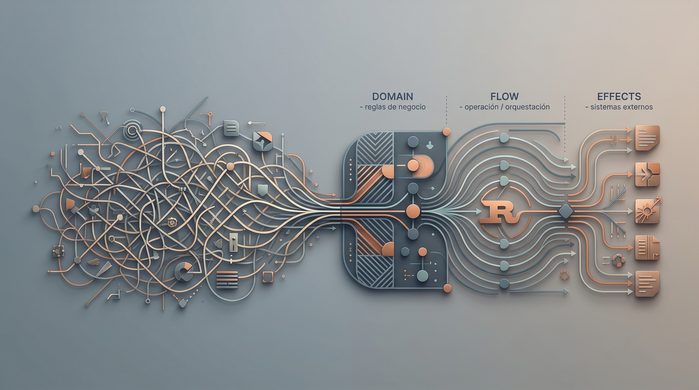
Cuando un sistema crece, también crece su complejidad. Cada línea de código introduce nuevas condiciones por probar y, si no están cubiertas, nuevos lugares donde puede aparecer un bug.. Por eso organizar el código se vuelve fundamental, y más aún cuando el equipo crece.
Y aquí es donde la arquitectura empieza a tomar importancia. No se trata solo de ordenar carpetas o separar archivos, sino de conseguir que el sistema pueda seguir creciendo sin que cada cambio termine haciendo más difícil entenderlo y mantenerlo.
La idea es poder evolucionar el sistema de forma natural, sin que el código termine convirtiéndose en un caos. Para conseguirlo existen muchos patrones y modelos:
- Clean Architecture
- Arquitectura Hexagonal
- Repositories
- Services
- DTOs
- Mappers
- Interfaces
- Etc
Son patrones que han sido probados en proyectos reales. Y aunque varios de ellos son agnósticos al lenguaje, muchas de sus implementaciones y ejemplos están muy ligados a lenguajes orientados a objetos (OOP): interfaces, inyección de dependencias, herencia, etc.
Cuando llegas a Rust, muchos de esos problemas se resuelven de otra manera. Algunas siguen teniendo sentido, otras cambian bastante y algunas simplemente no existen de la misma forma
La arquitectura debe fluir con el lenguaje, no pelear con él.
Donde me frustré
Cuando empecé a desarrollar en Rust intenté llevar esas arquitecturas a mi forma de trabajar, y siempre terminaba frustrado. Ninguna encajaba con la naturalidad que había experimentado en Java o C#.
El problema no era que fueran malas. Era que estaba trasladando modelos orientados a objetos (OOP) a un lenguaje que no está construido alrededor de ese modelo. Y uno de los mayores obstáculos fue, precisamente, el borrow checker.
La inyección de dependencias fue el caso que más me costó. No porque no se pudiera hacer en Rust, sino porque el modelo de ownership y borrowing hacía que algo tan simple como pasar una dependencia de un componente a otro dejara de ser tan directo como en lenguajes OOP. Había que resolver ownership, referencias y lifetimes, y la solución empezaba a sentirse más compleja que el problema original.
Una abstracción llevaba a otra:
- Un trait para abstraer un servicio.
- Una implementación concreta.
- Otra capa para resolver la dependencia.
- Referencias que debían vivir el tiempo suficiente.
- Lifetimes,
Arc,dyn.
Todo funcionaba, pero dejaba de sentirse natural. La arquitectura empezaba a añadir complejidad en lugar de quitarla, y terminaba pensando más en cómo mantener las abstracciones que en el problema que realmente quería resolver.
Cambiar de enfoque
Después de varios intentos dejé de copiar implementaciones y empecé a mirar los principios. Me hice estas preguntas:
- ¿Qué problema intentaba resolver cada patrón?
- ¿Qué responsabilidades querían separar?
- ¿Qué aportaba realmente valor?
- ¿Cómo podía resolver lo mismo con las herramientas que Rust ya trae?
De ahí nace Domain–Flow–Effects, o simplemente DFE: una propuesta para construir sistemas en Rust conservando las ideas que considero valiosas de esas arquitecturas, sin reproducir literalmente sus implementaciones.
No pretendo inventar algo completamente nuevo para problemas que ya conocemos. Propongo una forma diferente de organizarlos en Rust.
El problema empieza cuando el sistema deja de ser pequeño
Tomemos algo sencillo, una tienda online con un carrito de compras. Al principio, agregar un producto parece esto:
Agregar producto → Guardar producto
Pero cuando el sistema crece. Hay que comprobar que el producto existe, que está disponible, que la cantidad es válida, que no supera un máximo. Después aparecen descuentos, promociones, impuestos y un total. Lo que parecía un simple add_product() acaba con muchas reglas:
Agregar producto
      │
      ├── ¿Existe el producto?
      ├── ¿Está disponible?
      ├── ¿La cantidad es válida?
      ├── ¿Se puede agregar esta cantidad?
      ├── ¿Existe una promoción?
      └── Actualizar carrito
Y eso sigue siendo un ejemplo pequeño. El problema no es tener muchas reglas, sino no saber dónde vive cada una. Podemos acabar con una validación en el controller, otra en un service, otra en el repository y otra en el SQL. Quien modifique el carrito tendrá que buscar en varios lugares para descubrir cómo funciona de verdad.
Ahí es donde una arquitectura cumple su función. No solo organiza archivos: debe ayudarme a entender dónde ocurre cada cosa.
Cuatro conceptos
DFE distingue cuatro responsabilidades que pueden organizarse en estas carpetas. No hace falta crearlas todas si la operación no las necesita:
domain/ → conceptos y reglas del negocio, sin I/O
flows/ → consulta datos, aplica reglas y devuelve el resultado sin guardarlo
fx/ → funciones concretas de acceso a la DB y otros sistemas externos
api/ → recibe la petición, controla la transacción, guarda y coordina las consecuencias externas
No son cuatro capas porque sí. Cada una responde una pregunta distinta:
domain → ¿Qué reglas tiene mi negocio?
flows  → ¿Qué operación estoy ejecutando?
fx     → ¿Con qué sistema externo tengo que hablar?
api    → ¿Cómo entra y cómo se orquesta la operación?
Parece sencillo. Esa es la idea.
¿Por qué no lo llamé Service o UseCase?
Podría haberlos llamado services, use_cases y repositories. Habría sido más fácil de explicar, porque todos conocemos esos nombres. Y precisamente por eso no lo hice.
Cada nombre trae un modelo mental con sus hábitos. Un Service invita a crear una interfaz, una implementación y una capa de inyección. Un UseCase invita a crear un objeto por operación, con su input y su output. Un Repository invita a un trait y a un mapper. Son hábitos que en Java o C# tienen sentido, y que en Rust me llevaban a hacer cosas que no debía: dyn, Arc, lifetimes y capas que no resolvían ningún problema real.
Elegí Flow y Effects deliberadamente para romper esa inercia. Si la carpeta se llama services, tiendo a escribir un servicio. Si se llama flows, me pregunto qué operación estoy ejecutando. Y si se llama fx, tengo claro que ahí vive lo que toca el exterior, sin disfrazarlo de otra cosa.
No es una cuestión de estética. Es una forma de proteger el diseño de mis propios reflejos.
Domain
El domain contiene los conceptos propios del problema:
pub struct Cart {
    id: CartId,
    customer_id: CustomerId,
    items: Vec<CartItem>,
}

pub struct CartItem {
    product_id: ProductId,
    quantity: u32,
}
Aquí no sé nada de la base de datos. El carrito no necesita saber qué ORM usamos, ni conocer Redis, HTTP, gRPC o Kafka. El dominio debe poder expresar sus propias reglas:
impl Cart {
    pub fn add_product(
        &mut self,
        product_id: ProductId,
        quantity: u32,
    ) -> Result<(), CartError> {
        if quantity == 0 {
            return Err(CartError::InvalidQuantity);
        }

        // más reglas del carrito...

        Ok(())
    }
}
La regla pertenece al carrito. No al controller, no al repository, y desde luego no debería esconderse en una consulta SQL.
Effects
El dominio puede decidir que una cantidad igual a cero no es válida. Pero no puede saber por sí mismo si el producto existe en la base de datos, ni cuánto stock queda. Para eso hay que hablar con el exterior. Ahí entran los Effects.
En DFE, fx agrupa las operaciones que tocan el mundo exterior:
fx/
├── db/
├── cache/
└── events/
Dentro de fx/db:
pub async fn get_product(
    conn: &mut PgConnection,
    product_id: ProductId,
) -> Result<Option<Product>, DbError> {
    // SELECT ...
}

pub async fn update_cart(
    conn: &mut PgConnection,
    cart: &Cart,
) -> Result<(), DbError> {
    // UPDATE ...
}
Estas funciones no fingen ser otra cosa. Una función que ejecuta un SELECT hace un SELECT. No necesito esconderla detrás de tres interfaces para que parezca más desacoplada. El efecto está explícito.
¿Qué considero un efecto?
En DFE uso fx/ para agrupar las operaciones que interactúan con el exterior: consultar una base de datos, guardar información, acceder a una caché, publicar un evento o leer el reloj.
No uso el término como una clasificación de efectos de la programación funcional. Para organizar la operación, distingo entre obtener información y producir cambios sobre el sistema.
Consultar el stock no cambia por sí mismo el estado del negocio; guardar el carrito sí. Ambas operaciones viven en fx/db, pero no las llama el mismo lugar: el flow consulta y API guarda.
Eso no convierte las consultas en funciones puras. Pueden fallar, devolver resultados distintos o adquirir bloqueos. Y una consulta que ejecuta una mutación no se vuelve de solo lectura por llamarse SELECT.
La separación que me interesa es concreta: el flow obtiene información y prepara un resultado; API ejecuta la persistencia y coordina las demás acciones externas.
Flow
Agregar un producto al carrito no es solo una regla de dominio. Hay que obtener información externa y luego ejecutar una operación. Ahí entra flows:
flows/
└── cart/
    ├── add_product.rs
    ├── remove_product.rs
    └── checkout.rs
Conceptualmente, add_product es así:
API abre la transacción
 │
 ▼
AddProduct
 │
 ├── obtener carrito
 ├── obtener producto
 ├── comprobar disponibilidad
 ├── aplicar reglas del carrito
 └── devolver carrito modificado en memoria
 │
 ▼
API guarda mediante fx/db
 │
 ├── confirmar la transacción
 └── coordinar las consecuencias externas
Un Flow representa una operación concreta del sistema, con un comienzo y un objetivo claros; en este caso, AddProduct.
No abre ni confirma la transacción. API la controla y le presta su conexión para consultar los datos necesarios.
Su trabajo es obtener información, aplicar las reglas del dominio y devolver el resultado en memoria. Modificar un carrito en memoria no es lo mismo que guardarlo: la escritura queda en API, mediante fx/db.
La operación completa
pub async fn add_product(
    conn: &mut PgConnection,
    cart_id: CartId,
    product_id: ProductId,
    quantity: u32,
) -> Result<Cart, AddProductError> {
    let mut cart = fx::db::get_cart(&mut *conn, cart_id)
        .await?
        .ok_or(AddProductError::CartNotFound)?;

    let product = fx::db::get_product(&mut *conn, product_id)
        .await?
        .ok_or(AddProductError::ProductNotFound)?;

    if product.stock < quantity {
        return Err(AddProductError::InsufficientStock);
    }

    cart.add_product(product.id(), quantity)?;

    Ok(cart)
}
El ejemplo es deliberadamente sencillo. Lo importante no es el código exacto, sino poder leerlo y entender qué prepara la operación: obtengo el carrito, obtengo el producto, compruebo el stock y aplico las reglas del dominio. Devuelvo el carrito modificado en memoria; API se encarga de guardarlo. Es un recorte explicativo: el modelo del carrito y sus reglas completas deben comprobar también la cantidad acumulada, los límites y los posibles desbordamientos.
El Flow conoce a los efectos reales (y es a propósito)
Si vienes de Clean Architecture o de la Arquitectura Hexagonal, quizá notaste algo en el código anterior: el Flow llama directamente a fx::db::get_cart.
No hay una interfaz entre ambos, no hay inversión de dependencias y no se inyecta nada.
Desde ese punto de vista, el Flow está «contaminado»:: conoce la implementación real y depende de ella.
Es cierto, y lo asumo.
En esas arquitecturas, la interfaz existe para que la lógica no dependa de la implementación, de modo que puedas cambiar una sin tocar la otra. Es una solución a un problema real.
En Rust, parte de ese problema se puede abordar de otra manera.
Cuando un Flow llama directamente a fx::db, el acoplamiento está ahí y es visible. Si cambia la firma de get_cart, el compilador puede señalar los Flows que necesitan ser actualizados.
No intento eliminar todo acoplamiento. Intento que el acoplamiento que existe sea explícito, local y barato de mantener.
Por eso repetir UseCase, Repository y Mapper para cada servicio no ayuda: multiplica archivos y nombres sin aportar nada que el lenguaje no me dé ya.
Esto tiene un costo que prefiero decir claramente:
- Los tests de un Flow usan una base de datos real (por ejemplo con
sqlx::test) en lugar de mocks. Las reglas puras del dominio siguen probándose sin nada externo. - Si algún día necesito varias implementaciones reales de un efecto, por ejemplo dos proveedores de pago, un trait sigue siendo la herramienta correcta.
DFE no prohíbe las abstracciones. Solo evita crearlas por anticipado.
No abstraigo por si acaso. Abstraigo cuando hay algo real que intercambiar.
¿Y dónde queda la API?
La API adapta la petición y coordina la operación, pero no contiene las reglas del carrito. Abre la transacción, llama al flow y guarda el resultado mediante fx/db. En HTTP, por ejemplo, POST /cart/items:
let request = AddProductRequest::from(...);

let mut tx = state.db.begin().await?;

let cart = flows::cart::add_product(
    &mut *tx,
    request.cart_id,
    request.product_id,
    request.quantity,
).await?;

fx::db::update_cart(&mut *tx, &cart).await?;

tx.commit().await?;
La API controla la transacción. El flow consulta mediante la conexión prestada, aplica las reglas y devuelve el resultado. Después, API escribe y confirma.
Las consultas y la escritura usan la misma transacción. Eso no resuelve automáticamente todos los conflictos concurrentes: según la regla, pueden hacer falta restricciones, bloqueos o un nivel de aislamiento adecuado.
La API necesita saber qué pasos coordinar, no cómo se calcula cada regla del carrito.
HTTP ───────┐
            │
gRPC ───────┼──→ Flow
            │
otro API ───┘
La API también es el lugar donde coordino las acciones externas posteriores al commit, como invalidar una caché, enviar un correo o publicar un evento. Así, quien lee el handler ve qué ocurre después de guardar. Si una de esas acciones falla, la transacción ya quedó confirmada; ese error no se oculta ni se interpreta como si el guardado se hubiera revertido.
No todo necesita un Flow
En algunas implementaciones de Clean o Hexagonal, el camino termina siendo fijo: toda operación atraviesa las mismas capas, sea simple o compleja.
Leer un producto por su id recorre UseCase, Service y Repository, aunque al final sea un solo SELECT.
No quiero que DFE sea otra arquitectura rígida. Si la operación es:
GET /products/123
y solo necesito buscar un producto, basta con:
API → fx/db
Pero si la lectura tiene reglas (filtrar por permisos, calcular disponibilidad, aplicar condiciones), ya es una operación con comportamiento propio, y ahí tiene sentido un Flow.
API → Flow → fx/db
Lo mismo ocurre con las escrituras.
Una operación simple que solo persiste datos puede ir directamente al efecto:
API → fx/db
Si necesita validaciones y reglas de negocio:
API → Flow → fx/db
Cuando la coordinación ya no se lee con claridad dentro del handler, puedo extraerla a una función en api/actions/. Esa función sigue siendo parte de API: llama a los flows, guarda sus resultados y coordina las acciones externas.
api/actions/ es una opción para ordenar esa coordinación, no una quinta capa obligatoria.
API → Action → Flow → fx
La estructura aparece según la operación, no al revés.
Si una operación simple se vuelve compleja mañana, añado el Flow en ese punto. No tuve que pagar desde el principio por capas que todavía no necesitaba.
La regla que sigo es:
Si existe una regla del negocio, probablemente necesito un Flow.
Si solo hago una operación técnica, voy directo al efecto.
DFE no es una arquitectura de capas
No quiero que el desarrollador piense «estoy en la API, así que tengo que ir a Flow». Quiero que se pregunte: ¿esta operación tiene reglas?
Sin reglas:
API → FX
Con reglas:
API → Flow → FX
Operación más compleja:
API → Action → Flow → FX
No hay que atravesar capas por obligación. La estructura aparece cuando el problema lo necesita.
Estos esquemas muestran las llamadas entre las piezas, no todos los pasos de la operación. El flow consulta mediante fx/db, aplica las reglas y devuelve el resultado. Si hay cambios que guardar, API los persiste mediante fx/db y confirma la transacción. Cuando uso api/actions/, esa coordinación sigue siendo parte de API.
La regla que lo resume todo
Si una capa no introduce una regla, un límite o una semántica clara, probablemente no necesito esa capa.
Por eso no existe un Repository solo porque la arquitectura diga que debe existir. No hay un Service solo para poner algo entre la API y la base de datos, ni un Mapper solo porque dos estructuras se llamen distinto, ni un UseCase que únicamente llama a otra función. Cada pieza tiene que aportar algo. Si no aporta nada, la quito.
No se trata de tener menos arquitectura, sino de que cada pieza tenga una razón para existir.
Aprovechar lo que Rust ya ofrece
DFE no elimina las ideas de Clean Architecture o de la Arquitectura Hexagonal; muchas siguen siendo útiles. Lo que cuestiono es copiar también su forma de implementarlas cuando trabajo con Rust.
Rust ya tiene ownership, borrowing, enums, traits, Result, tipos fuertes y un compilador que puede ser parte importante de las garantías de nuestro diseño. Prefiero construir la arquitectura alrededor de esas herramientas antes que hacer que Rust se comporte como Java o C#.
Cuándo DFE no es la mejor opción
DFE nace del desarrollo backend: servicios que reciben peticiones (HTTP, gRPC), aplican reglas de negocio y persisten datos. Ahí es donde aparecen los problemas que intento resolver: reglas dispersas, capas que no aportan y operaciones difíciles de rastrear.
No pretende ser una arquitectura universal para Rust.
Otros tipos de software tienen sus propias arquitecturas, pensadas para sus propios problemas:
- Kernels, drivers y sistemas embebidos: el hardware, la memoria y los tiempos mandan sobre el diseño. La separación entre «regla de negocio» y «efecto» no es el eje principal.
- Librerías, compiladores y motores (juegos, bases de datos, parsers): su estructura la dicta el dominio técnico, no un flujo de peticiones.
- CLIs y scripts pequeños: una estructura plana suele ser suficiente.
Incluso dentro del backend, hay casos donde no es la mejor opción:
- Equipos que ya dominan otra arquitectura y tienen código existente que funciona: migrar puede costar más de lo que aporta.
- Sistemas que necesitan intercambiar implementaciones reales (varios proveedores de pago, por ejemplo): los traits siguen siendo la herramienta correcta. DFE no lo prohíbe; solo pide que exista una razón real.
DFE es una propuesta que me funciona en backend y que sigo refinando. No es una verdad universal.
El objetivo
El objetivo de DFE no es una estructura de carpetas bonita. Es poder abrir un proyecto y responder rápido a tres preguntas:
¿Dónde está la regla?
¿Dónde está la operación?
¿Dónde ocurre el efecto?
Si quiero cambiar la regla que impide una cantidad inválida, la encuentro en el dominio.
Si quiero cambiar cómo se agrega un producto, encuentro el Flow.
Si quiero cambiar cómo se guarda el carrito en la base de datos, encuentro el efecto.
Sin recorrer todo el sistema.
Ese es el principio sobre el que construyo DFE: Domain–Flow–Effects, una arquitectura pensada para que el código pueda crecer sin que entenderlo se vuelva cada vez más difícil.
La arquitectura debe fluir con el lenguaje, no pelear con él.
Este es solo el comienzo.
En un próximo artículo publicaré el Manifiesto DFE, donde voy a profundizar en los principios que hay detrás de esta propuesta, sus reglas y cómo aplicarlos cuando un sistema empieza a crecer.
Actualización — octubre de 2026
El Manifiesto DFE ya está publicado. Allí explico sus principios, reglas, ejemplos prácticos y alcance.
